Claude Sonnet 5.5: מהיר ב-30% וזול יותר לכל משימה, באותו מחיר לטוקן
המחיר לטוקן לא זז. מה שירד הוא מספר הטוקנים שהוא צריך כדי לגמור את העבודה.
Sonnet 5.5 מול Sonnet 5
ב-28 בספטמבר Anthropic השיקה את Claude Sonnet 5.5, הדגם השני במשפחת Claude 5.5 אחרי Opus 5.5. Sonnet הוא הדגם של Claude לעבודה היומיומית: מהיר וזול יותר מ-Opus ומתאים לרוב המשימות. לפי ההכרזה, הגרסה החדשה כותבת את התשובה מהר ב-30% ויותר מ-Sonnet 5. המחיר לטוקן לא השתנה, אבל ברוב המשימות הוא צריך הרבה פחות טוקנים. לכן משימה עולה, לפי Anthropic, עד 30% פחות.
Anthropic מציגה אותו כהשלמה מהירה וזולה ל-Opus 5.5. את Opus היא מייעדת לעבודה מורכבת שדורשת שיקול דעת. את Sonnet היא מייעדת למשימות יומיומיות מוגדרות, לתיקון באגים וליצירת מסמכים, מצגות וגיליונות. במבחנים הוא קופץ הרבה מעל Sonnet 5 ובחלקם כמעט משתווה ל-Opus 5.5.
איפה אפשר להשתמש בו
ב-claude.ai ובאפליקציות, לכל המסלולים כולל החינמי. ב-Claude Code בוחרים בו בפקודה /model sonnet. ב-API השם שלו הוא claude-sonnet-5-5 והוא זמין גם ב-Amazon Bedrock, ב-Google Cloud וב-Microsoft Foundry.
אותו מחיר לטוקן, קבלה קצרה יותר
ב-API משלמים לפי טוקנים, חלקים קטנים של טקסט שהמודל קורא וכותב. Sonnet 5.5 עולה בדיוק כמו Sonnet 5: 2 דולר למיליון טוקנים שנכנסים למודל ו-10 דולר למיליון שיוצאים ממנו. החיסכון מגיע ממקום אחר: כדי לגמור את אותה עבודה הוא חושב פחות וכותב פחות. גם הזמן מתקצר משתי סיבות. כל טוקן יוצא מהר יותר ויש פחות טוקנים לחכות להם.
בדף ההשקה Anthropic הריצה את שני הדגמים על אותן בקשות ופרסמה כמה טוקנים כל אחד מהם צרך. ככה נראית אחת הריצות אם מדפיסים אותה כקבלה:
הבקשה, זהה לשניהםשעון שבנוי מ-24 שעונים קטנים, בקובץ HTML אחד
המחיר, זהה לשניהם10 דולר למיליון טוקנים של פלט
בבקשה הזו, שעון שבנוי מ-24 שעונים קטנים, Sonnet 5 חשב 24,504 טוקנים לפני שכתב את הקוד. Sonnet 5.5 חשב 11,448, פחות מחצי. הקוד עצמו יצא באורך דומה. בסך הכול הוא צרך 48% פחות טוקנים ועלות הפלט ירדה מ-0.28 דולר ל-0.14 דולר. לפי הקצב שבהשוואה של Anthropic, התשובה מגיעה אחרי כדקה וחצי במקום כ-4 דקות.
זו הדוגמה הקיצונית מבין השלוש שבדף ההשקה. בבקשות שדורשות פחות מחשבה החיסכון בטוקנים קטן בהרבה, אבל המהירות נשארת:
| הבקשה | Sonnet 5 | Sonnet 5.5 | פחות טוקנים |
|---|---|---|---|
| שעון שבנוי מ-24 שעונים קטנים | 27,710 טוקנים242 שניות | 14,386 טוקנים97 שניות | 48% |
| להקה של 400 זרזירים | 4,649 טוקנים43 שניות | 4,158 טוקנים29 שניות | 11% |
| רוח שמעצבת דיונות חול | 3,088 טוקנים28 שניות | 2,720 טוקנים19 שניות | 12% |
כל הבקשות ביקשו תוצאה בקובץ HTML אחד. בבקשת הדיונות שני הדגמים כתבו את הקוד בלי שלב חשיבה. הזמנים מחושבים כמו בהשוואה של Anthropic, לפי 115 טוקנים לשנייה ל-Sonnet 5 ו-150 ל-Sonnet 5.5.
זה מסביר את הניסוח של Anthropic: כתיבה מהירה ב-30% ויותר כמעט בכל מקום ועלות נמוכה "עד" 30% למשימה. כמה תחסכו תלוי בכמה המשימה דורשת מחשבה. גם הלקוחות שמופיעים בדף של Sonnet מדווחים על טווח רחב. ב-Slack הוא הצליח יותר מ-Sonnet 5 כמעט בכל הבדיקות של ה-Slackbot, עם כ-14% פחות טוקנים של פלט. לקוח אחר הריץ אותו על 2,441 משימות פיננסיות וקיבל ציון גבוה יותר עם כ-121 אלף טוקנים לתשובה, במקום 497 אלף של Sonnet 5.
איך בוחרים בו ומה עושה Effort
ב-claude.ai ובאפליקציות פותחים את בורר הדגמים שמתחת לתיבת הכתיבה. Sonnet 5.5 תפס שם את המקום של Sonnet 5 ברשימה הראשית. הגרסה הקודמת עברה לתפריט More models ואפשר עדיין לבחור בה.
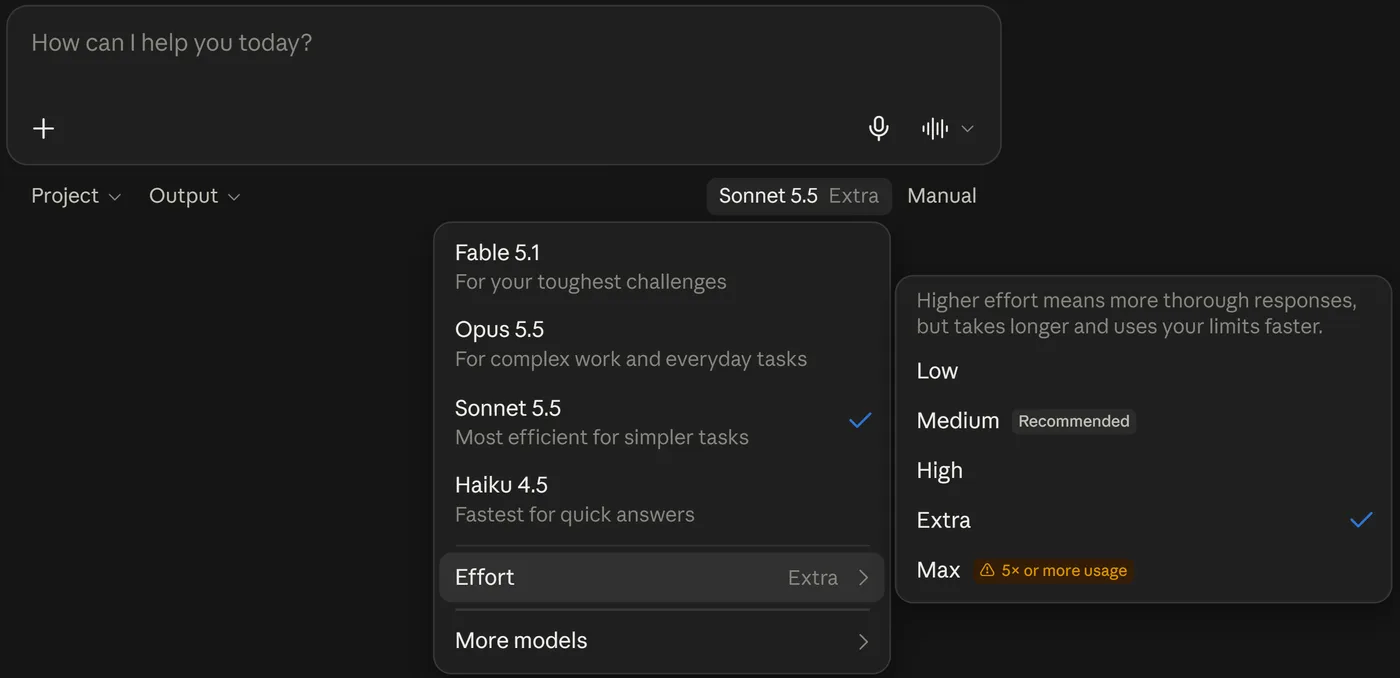
Effort, רמת המאמץ, קובע כמה המודל חושב לפני שהוא עונה. באפליקציות וב-Claude Code ברירת המחדל היא Medium, שהבורר מסמן כמומלצת. ב-API ברירת המחדל היא High. ליד Max מופיעה אזהרה שהיא צורכת פי 5 ויותר מהמכסה, אז כדאי לשמור אותה לבעיות קשות באמת.
גם ברמה הרגילה הקפיצה גדולה. ב-Terminal-Bench 4.0, מבחן של משימות מרובות שלבים בשורת הפקודה, Sonnet 5.5 ברמת Medium קיבל 28.8%. הציון הגבוה ביותר של Sonnet 5, ברמת Max, היה 10.3%. העלות לניסיון הייתה 0.83 דולר מול 11.62 דולר. ב-CursorBench, שבנוי ממשימות קוד אמיתיות מתוך Cursor, כבר ברמת Low הוא עקף את הציון הכי גבוה של Sonnet 5 בפחות מעשירית מהעלות.
כמה הוא השתפר ואיפה Opus 5.5 עדיין לפניו
Anthropic פרסמה טבלה של 8 מבחנים. בכולם Sonnet 5.5 עולה על Sonnet 5, בחלקם בפער עצום. ברוב המבחנים הוא מתקרב ל-Opus 5.5 ובאחד, Terminal-Bench, אפילו עוקף אותו:
הקפיצה מ-Sonnet 5 ל-Sonnet 5.5, מול Opus 5.5
- Sonnet 5
- Sonnet 5.5
- Opus 5.5
כל הנתונים בטבלה, כולל GPT-6 Sol
| מבחן | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| קוד בשורת הפקודהTerminal-Bench 4.0 | 70.6% | 10.3% | 66.4% | אין נתון |
| קוד שנכנס לפרויקטFrontierCode 1.1 | 52.1%xhigh; ב-max 46.2% | 42.4% | 54.4% | 49.3% |
| משימות קוד מ-CursorCursorBench 4.0 | 55.5% | 34.1% | 57.8% | אין נתון |
| שאלות קשות מכל התחומיםHumanity's Last Exam | 64.5% | 54.9% | 67.7% | אין נתון |
| שימוש במחשבOSWorld 2.1 | 80.1% | 57.0% | 81.8% | אין נתון |
| קריאת גרפים מתמונהChartography | 61.6% | 15.6% | 64.4% | 53.6% |
| עבודה מקצועית ב-44 מקצועותGDPval-AA v2.1 | 1,844 | 1,449 | 1,846 | 1,487 |
| עבודה משרדית ארוכהAA-Briefcase v1.1 | 1,811 | 1,359 | 1,822 | 1,483 |
מקור: הטבלה והגרפים בהכרזה של Anthropic, 28.9.2026. הציונים של כל הדגמים ברמת המאמץ המקסימלית, חוץ משניים: Sonnet 5.5 ב-FrontierCode מוצג ברמת xhigh (ב-Max קיבל 46.2%) ו-Opus 5.5 ב-Terminal-Bench ברמת xhigh. GDPval-AA ו-AA-Briefcase נמדדים בדירוג Elo, לכן הם על ציר נפרד.
הפערים הגדולים ביותר הם בקוד בשורת הפקודה, מ-10.3% ל-70.6% ובקריאת גרפים מתמונה, מ-15.6% ל-61.6%. בעבודה משרדית, במבחן GDPval-AA שבודק משימות אמיתיות ב-44 מקצועות, הוא קיבל 1,844 נקודות Elo. זה 2 נקודות פחות מ-Opus 5.5 וכ-400 יותר מ-Sonnet 5. מול GPT-6 Sol של OpenAI, שמופיע ב-4 מהמבחנים, Sonnet 5.5 מוביל בשלושה. בקוד שנכנס לפרויקט (FrontierCode) הוא מוביל רק ברמת xhigh.
Anthropic עצמה מסייגת: המבחנים מראים רק חלק מהתמונה. לפי הבדיקות שלה ושל בודקים חיצוניים, Opus 5.5 עדיין חזק ממנו בבירור בעבודה מורכבת ופתוחה שדורשת שיקול דעת לאורך זמן.
במה הוא טוב: קוד, מסמכים ומצגות
בקוד, בודקים מוקדמים סיפרו שהוא מבין מהר בסיס קוד חדש ומאחד קריאות לכלים, כך שהוא מגיע לתוצאה בפחות צעדים. ב-FrontierCode, שבודק אם שינויי הקוד של סוכן היו נכנסים לפרויקט, ברמת High הוא קיבל 10 נקודות יותר מ-Sonnet 5 באותה רמה, בעלות נמוכה פי 15 בערך. ב-Epic Games כתבו שבבדיקות שלהם הוא עמד ברף שמצפים לו מדגם בדרגה גבוהה יותר, עבד על עשרות אלפי שורות קוד והחזיק משימות של כמה שעות.
בעבודה משרדית Anthropic מדגישה את העין שלו לעיצוב: הוא מוסיף ליטוש לממשקים ויודע לעבוד לפי תבנית מצגת, כך שנשאר מעט לתקן. בניסוי פנימי הוא קיבל את חומרי הדוח הרבעוני של חברה ציבורית, תמלולי שיחות ותבנית שקפים. הוא התבקש להכין סקירה תפעולית של 10 שקפים. שני מומחים קבעו שהטיוטה הראשונה מוכנה לשליחה כמו שהיא.
עוד פרט מההכרזה: זה הדגם הראשון מסדרת Sonnet שסיים את המשחק Pokémon Red כשהוא רואה רק צילומי מסך.
מתי עדיין לבחור ב-Opus 5.5
כשהמשימה ברורה והתוצאה קלה לבדיקה, למשל תיקון באג, עדכון מצגת או סידור גיליון, Sonnet 5.5 יסיים מהר יותר ויעלה פחות. כשהמודל צריך להחליט בעצמו מה נכון לאורך הרבה צעדים, כמו בתכנון מערכת או בניתוח שאין לו תשובה אחת, עדיף לעבור ל-Opus 5.5. ב-API הוא גם עולה פי 2:
| למיליון טוקנים | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| טוקנים שנכנסים | $2 | $4 |
| טוקנים שיוצאים | $10 | $20 |
| קריאה מהמטמון | $0.20 | $0.20 |
| כתיבה למטמון ל-5 דקות | $2.50 | $5 |
דולרים למיליון טוקנים, לפי ההכרזה. Sonnet 5 עולה בדיוק כמו Sonnet 5.5. ב-Batch API המחיר חצי ובמטמון לשעה הכתיבה עולה 4 דולר למיליון ב-Sonnet 5.5.
בקשות אבטחה יכולות לעבור ל-Sonnet 5
Sonnet 5.5 הוא ה-Sonnet הראשון שמגיע עם הגנות סייבר כמו של הדגמים החזקים של Anthropic, כי היכולות שלו באבטחה קרובות לאלה של Opus 5. בדיקות אוטומטיות רצות על כל בקשה ועל כל מה שהמודל קורא, כולל זיכרון, תוכן ממחברים, תוצאות חיפוש וקבצים.
בקשות סייבר בסיכון גבוה, כמו כתיבת exploit, סריקת פגיעויות בקבצים בינאריים או בדיקות חדירה, עוברות אוטומטית ל-Sonnet 5 באותה שיחה. מופיעה הודעה על ההחלפה והתשובה מסומנת בשם הדגם שענה. סריקת קוד מקור לאיתור חולשות ותיקון באגים בקוד שלכם עובדים כרגיל. בקשות בביולוגיה שעלולות לעזור לגרום נזק חמור נחסמות לגמרי, בלי מעבר לדגם אחר. הפירוט המלא במרכז העזרה של Claude.
אחרי החלפה, השיחה נשארת על Sonnet 5
הבורר נשאר על Sonnet 5 עד סוף השיחה. אפשר לחזור ל-Sonnet 5.5 ידנית, אבל אם הבקשה המקורית עדיין בשיחה, ההגנה עלולה להחליף שוב. מי שמעדיף שהשיחה תעצור במקום לעבור דגם יכול לכבות את המתג Switch models when a message is flagged בעמוד ההגדרות Settings > Capabilities.
עוד חסימה חדשה: בקשות לחשוף את כל שרשרת המחשבה של המודל מילה במילה. Anthropic מסבירה שזו הגנה מפני העתקת היכולות של המודל. שאלה כמו "למה עשית את זה?" עובדת כרגיל.
למפתחים: מה משתנה ב-API
השם של הדגם הוא claude-sonnet-5-5, עם חלון הקשר של מיליון טוקנים ותשובה של עד 128 אלף טוקנים. חוץ מה-API של Anthropic הוא זמין גם ב-Amazon Bedrock, ב-Google Cloud, ב-Microsoft Foundry וב-Claude Platform on AWS. ב-Claude Code הכינוי sonnet מצביע עליו מגרסה 2.1.284, אבל ברירת המחדל שם נשארת Opus 5.5.
מי שעובר מ-Sonnet 5 צריך לבדוק 5 שינויים ששוברים קוד קיים. הפירוט המלא בתיעוד של Anthropic ובמדריך המעבר:
- כיבוי החשיבה השתנה. ההגדרה
thinking: {type: "disabled"}מחזירה עכשיו שגיאת 400. במקומה שולחיםthinking: {type: "between_tools"}, שמבטלת את החשיבה לפני התשובה ומשאירה רק הערות קצרות בין קריאות לכלים. היא עובדת רק ברמות low, medium ו-high. - אי אפשר לכפות שימוש בכלי. האפשרות
tool_choiceמסוג any או tool מחזירה 400. משתמשים באפשרות auto עםstrict: trueוכותבים בהנחיה מתי להשתמש בכלי. - בלוקי החשיבה קשורים לדגם ולשיחה. Sonnet 5.5 קורא בלוקים של Sonnet 5 ושל דגמים ישנים יותר, אבל שום דגם אחר לא קורא את הבלוקים שלו. בחשבונות שנפתחו מ-31 באוגוסט 2026, שינוי בהנחיית המערכת, בכלים או בהודעה קודמת לפני ששולחים שוב בלוק חשיבה מחזיר שגיאה.
- שימוש במחשב רק דרך ה-toolset החדש. ב-API וב-Google Cloud הכלי הישן
computer_20251124נדחה וצריך לעבור אלcomputer_toolset_20260801. ב-Amazon Bedrock הכלי הישן עדיין עובד. - כלי ה-advisor לא מקבל את Opus 4.8, Opus 4.7 ו-Sonnet 5 כיועצים.
יש גם שינוי שלא שובר בקשות: הטקסט שהמודל כותב בין קריאות לכלים מגיע עכשיו בבלוקי thinking. אפליקציה שמציגה אותו למשתמשים תשתתק בין הקריאות עד שתגדיר ערך display שמחזיר אותו. גם הגנות הסייבר עובדות אחרת ב-API: בקשה שנחסמת לא עוברת ל-Sonnet 5 מעצמה. מקבלים תשובת 200 עם סיבת עצירה, עד שמגדירים fallback.
שאלות נפוצות
האם Sonnet 5.5 זמין במנוי החינמי?
כן. לפי Anthropic, כל אחד יכול לשוחח איתו ב-claude.ai, באתר ובאפליקציות ל-iOS ול-Android. מגבלות השימוש של המסלול החינמי עדיין חלות. Claude Code דורש מנוי בתשלום וה-API מחויב בנפרד לפי שימוש.
כמה עולה Sonnet 5.5 ב-API?
2 דולר למיליון טוקנים שנכנסים ו-10 דולר למיליון שיוצאים, בדיוק כמו Sonnet 5. קריאה מהמטמון עולה 0.20 דולר למיליון וב-Batch API המחיר חצי. בדרך כלל משימה עולה פחות, כי הוא צריך פחות טוקנים. Anthropic מעריכה עד 30% פחות.
מה ההבדל בינו לבין Opus 5.5?
Sonnet 5.5 מהיר יותר, עולה חצי ומיועד למשימות יומיומיות מוגדרות. Opus 5.5 מיועד לעבודה מורכבת ופתוחה שדורשת שיקול דעת לאורך זמן. במבחנים הם קרובים, אבל לפי Anthropic, Opus 5.5 עדיין חזק ממנו בבירור בעבודה כזו.
האם הוא מחליף את Sonnet 5 לבד?
ב-claude.ai הוא תפס את המקום של Sonnet 5 ברשימה הראשית של בורר הדגמים. Sonnet 5 עבר ל-More models. ב-Claude Code הכינוי sonnet מצביע עליו מגרסה 2.1.284, אבל ברירת המחדל שם נשארת Opus 5.5. ב-API מחליפים ידנית את שם הדגם ל-claude-sonnet-5-5.
אפשר לכבות את החשיבה?
ב-API כן, עם ההגדרה thinking: {type: "between_tools"}. באפליקציות קובעים רק את רמת המאמץ והנמוכה ביותר היא Low.
למה השיחה עברה פתאום ל-Sonnet 5?
כנראה שהבקשה סומנה על ידי הגנות הסייבר או ההגנות על פיתוח דגמי AI מתקדמים. במקרה כזה Claude מריץ אותה מחדש על Sonnet 5 באותה שיחה ומציג הודעה על ההחלפה. אפשר לכבות את המעבר האוטומטי בעמוד ההגדרות Settings > Capabilities.
מתי יגיע Haiku 5.5?
לפי Anthropic, בשבועות הקרובים. תאריך מדויק עוד אין.
השורה התחתונה
למשימות היומיום Sonnet 5.5 הוא ברירת מחדל טובה: הוא זמין גם במסלול החינמי, כותב מהר יותר מ-Sonnet 5 ועולה אותו דבר לטוקן. מי שמשלם לפי טוקנים ירגיש את החיסכון בעיקר במשימות שבהן Sonnet 5 נהג לחשוב הרבה. למשימה פתוחה שדורשת שיקול דעת לאורך הרבה צעדים, כדאי להמשיך עם Opus 5.5.
ההכרזה הרשמית של Anthropicanthropic.comעוד באתר: ההשקה של Claude Opus 5.5, ההשקה של Claude Sonnet 5 וגם הצ'אט ו-Cowork של Claude שהתאחדו.
הירשמו לעדכונים במייל
רוצים להישאר צעד אחד קדימה?
עדכונים על כלי AI, מדריכים וטיפים - ישר למייל. בלי ספאם.